Claude Sonnet 4.6 vs Gemini 3 Pro vs GPT-5.2: ¿cuál programa (y escribe) realmente mejor en 2026?
Febrero de 2026. Tres IA. Un solo ganador, y no es el que crees.
Se lo puse encima de la mesa a mis socios la semana pasada: «Si tuvieras que quedarte con UNA sola herramienta de IA para programar y redactar, ¿cuál sería?» Silencio. Porque la respuesta real no está en las notas de prensa. Está en los benchmarks, en la factura de fin de mes y en lo que haces de verdad.
He probado las tres. Esto es lo que he encontrado: datos, fricción y todo lo demás.
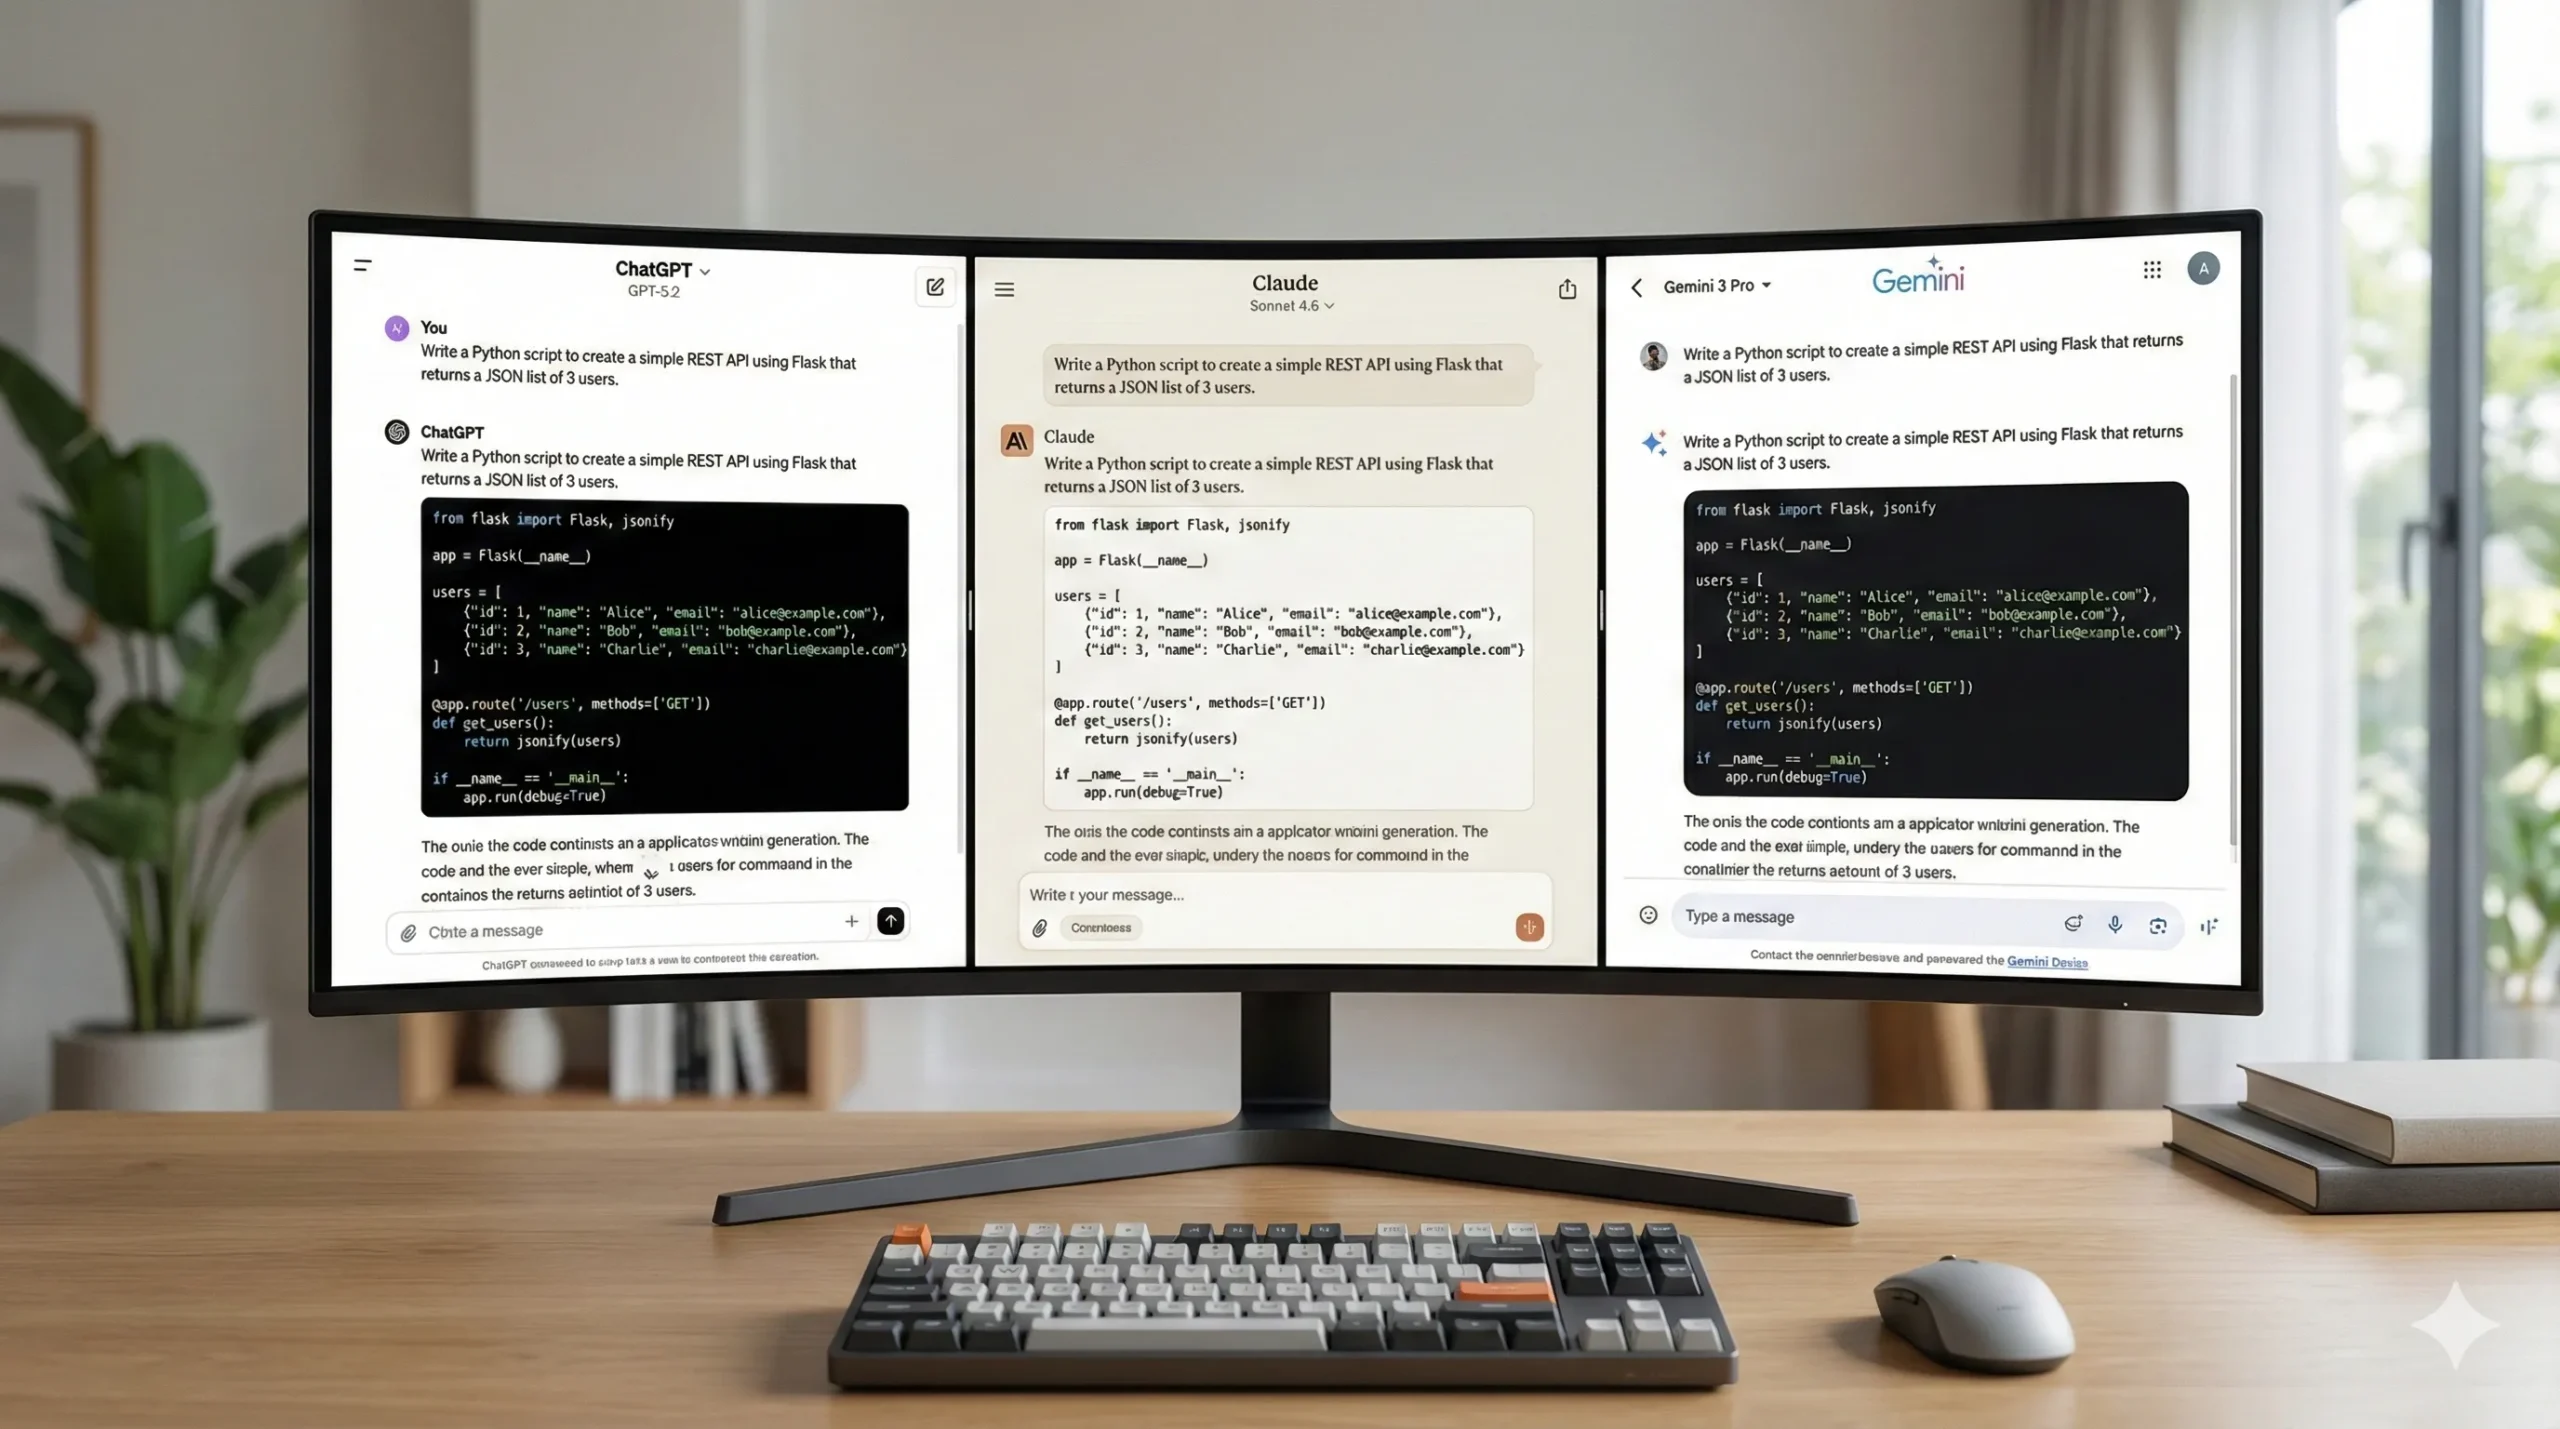
Captura lado a lado de Claude.ai, Google Gemini y ChatGPT con una tarea de código en curso
Lo que quieres saber (respuesta directa)
La respuesta corta: Claude Sonnet 4.6 domina en código complejo y redacción larga. Gemini 3 Pro arrasa en los proyectos grandes gracias a su ventana de 1M tokens. GPT-5.2 sigue siendo el más polivalente y el mejor integrado. Tu elección depende de tu caso de uso, no de un ranking universal.
| Criterio | Claude Sonnet 4.6 | Gemini 3 Pro | GPT-5.2 |
|---|---|---|---|
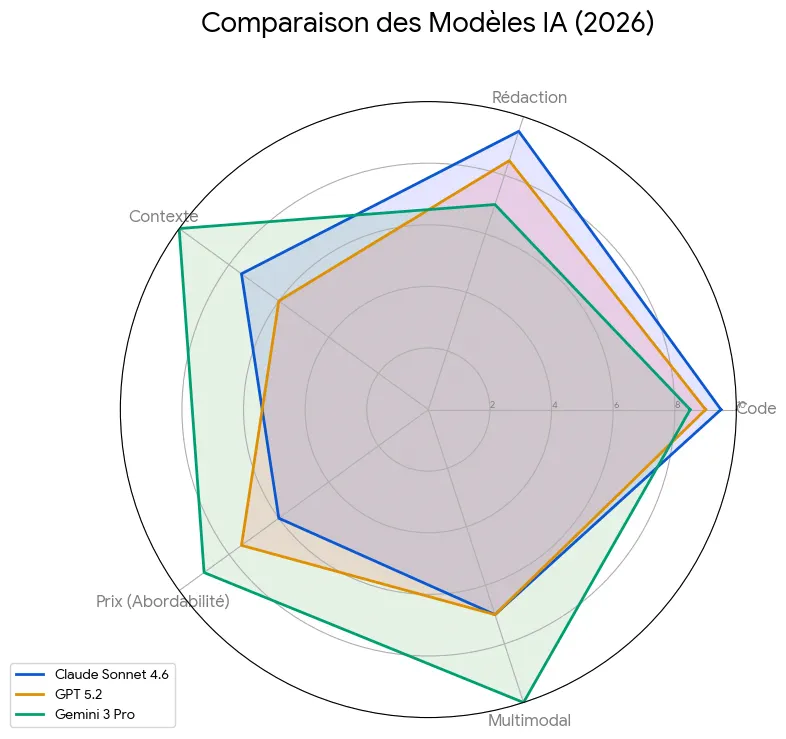
| Código (SWE-bench) | 🥇 77,2 % | 🥉 73,1 % | 🥈 74,9 % |
| Redacción / Documentación | 🥇 Natural, fluido | 🥉 Técnico | 🥈 Preciso |
| Ventana de contexto | 200K (1M en beta) | 1M tokens | 128K |
| Precio (entrada / M tokens) | ~3 $/M | 2 $/M | Variable |
| Multimodal | Texto + Imagen | Texto, Imagen, Audio, Vídeo | Texto + Imagen |
| Mejor para | Código largo y redacción | Codebases grandes, vídeo | Uso diario polivalente |
Claude Sonnet 4.6: el nuevo jefe del código
Publicado el 15 de febrero de 2026. Sí, hace 48 horas, justo cuando escribo estas líneas.
Anthropic soltó Claude Sonnet 4.6 el 15 de febrero de 2026 y es una actualización sustancial. No es un golpe de marketing: los números lo confirman.
Lo que cambia de verdad con Sonnet 4.6:
- Puntuación SWE-bench Verified de 77,2 %: la mejor del mercado en bugs reales
- 94 % en el benchmark «computer use» de Anthropic (navegar por formularios complejos, hojas de cálculo)
- Introduce el parámetro
effort(low / medium / high / max) para equilibrar velocidad, coste y rendimiento - Ventana de 200K tokens (1M tokens en beta)
- Resultados «nivel Opus» a precio de Sonnet
La diferencia que los devs han notado de verdad: en un codebase de 15.000 líneas, Claude Sonnet 4.6 encuentra el bug sin que le indiques el archivo en cuestión. Navega. GPT-5.2 todavía pregunta a menudo dónde buscar.
💬 «Sonnet 4.6 ya es excelente en correcciones de código complejas, sobre todo cuando la búsqueda dentro de grandes codebases es esencial.», según Anthropic en su blog oficial
¿Para quién? Desarrolladores en solitario, freelances de código, redactores de documentación técnica.
Gemini 3 Pro: el gigante silencioso
Disponible desde noviembre de 2025, desplegado para todos el 11 de febrero de 2026.
Google lanzó Gemini 3 Pro el 18 de noviembre de 2025 y su despliegue global acaba de completarse. Es la bestia de carga de los tres.
Sus cartas maestras:
- 1 millón de tokens de contexto (ningún otro se acerca en uso estándar)
- Multimodalidad nativa: texto, imagen, audio, vídeo
- «El mejor modelo de vibe coding» según Google mismo (ya sé que es fácil decirlo)
- Puntuación SWE-bench: 73,1 %, tercero, pero la diferencia es de solo 4 puntos
- El precio más competitivo entre los modelos premium: 2 $/M tokens de entrada
Lo que he aprendido de verdad: cuando tienes que entender un codebase entero en contexto, Gemini 3 Pro está en otra categoría. Ningún otro lo hace igual de bien. Cargué un proyecto WordPress completo (tema + plugins propios) e identificó un conflicto de hooks que yo habría tardado una hora en encontrar a mano.
En cambio, y este es el reverso, para la redacción creativa o los artículos de blog sigue siendo el más «robótico» de los tres. El texto sale técnico, limpio, pero frío.
¿Para quién? Equipos de desarrollo, arquitectos de software, proyectos con archivos grandes que analizar.
GPT-5.2: el campeón de la polivalencia
¿Sigue siendo la referencia para el uso diario?
OpenAI y GPT-5.2 están en una posición paradójica: ya no ganan los benchmarks de código frente a Claude, pero siguen siendo la herramienta más usada del mundo con 800 millones de usuarios semanales.
Sus puntos fuertes reales:
- SWE-bench Verified: 74,9 %, sólido, segundo puesto
- Aider Polyglot: 88 % con el modo reasoning activado (+61 puntos frente a sin reasoning)
- Ventana de 400K tokens de entrada (frente a 128K en la API estándar)
- El mejor para JavaScript/TypeScript/React: 90-92 % de precisión
- Ecosistema rico (plugins, integraciones, batch processing)
El reasoning marca toda la diferencia en GPT-5.2. Sin el modo «thinking», las distancias con Claude se agrandan. Con él, vuelve a la carrera.
¿Para quién? Desarrolladores full-stack web, equipos ya integrados en el ecosistema OpenAI, profesionales que alternan código y redacción a diario.
Benchmark de código: el ranking oficial de 2026
SWE-bench Verified, la referencia industrial sobre bugs reales de GitHub
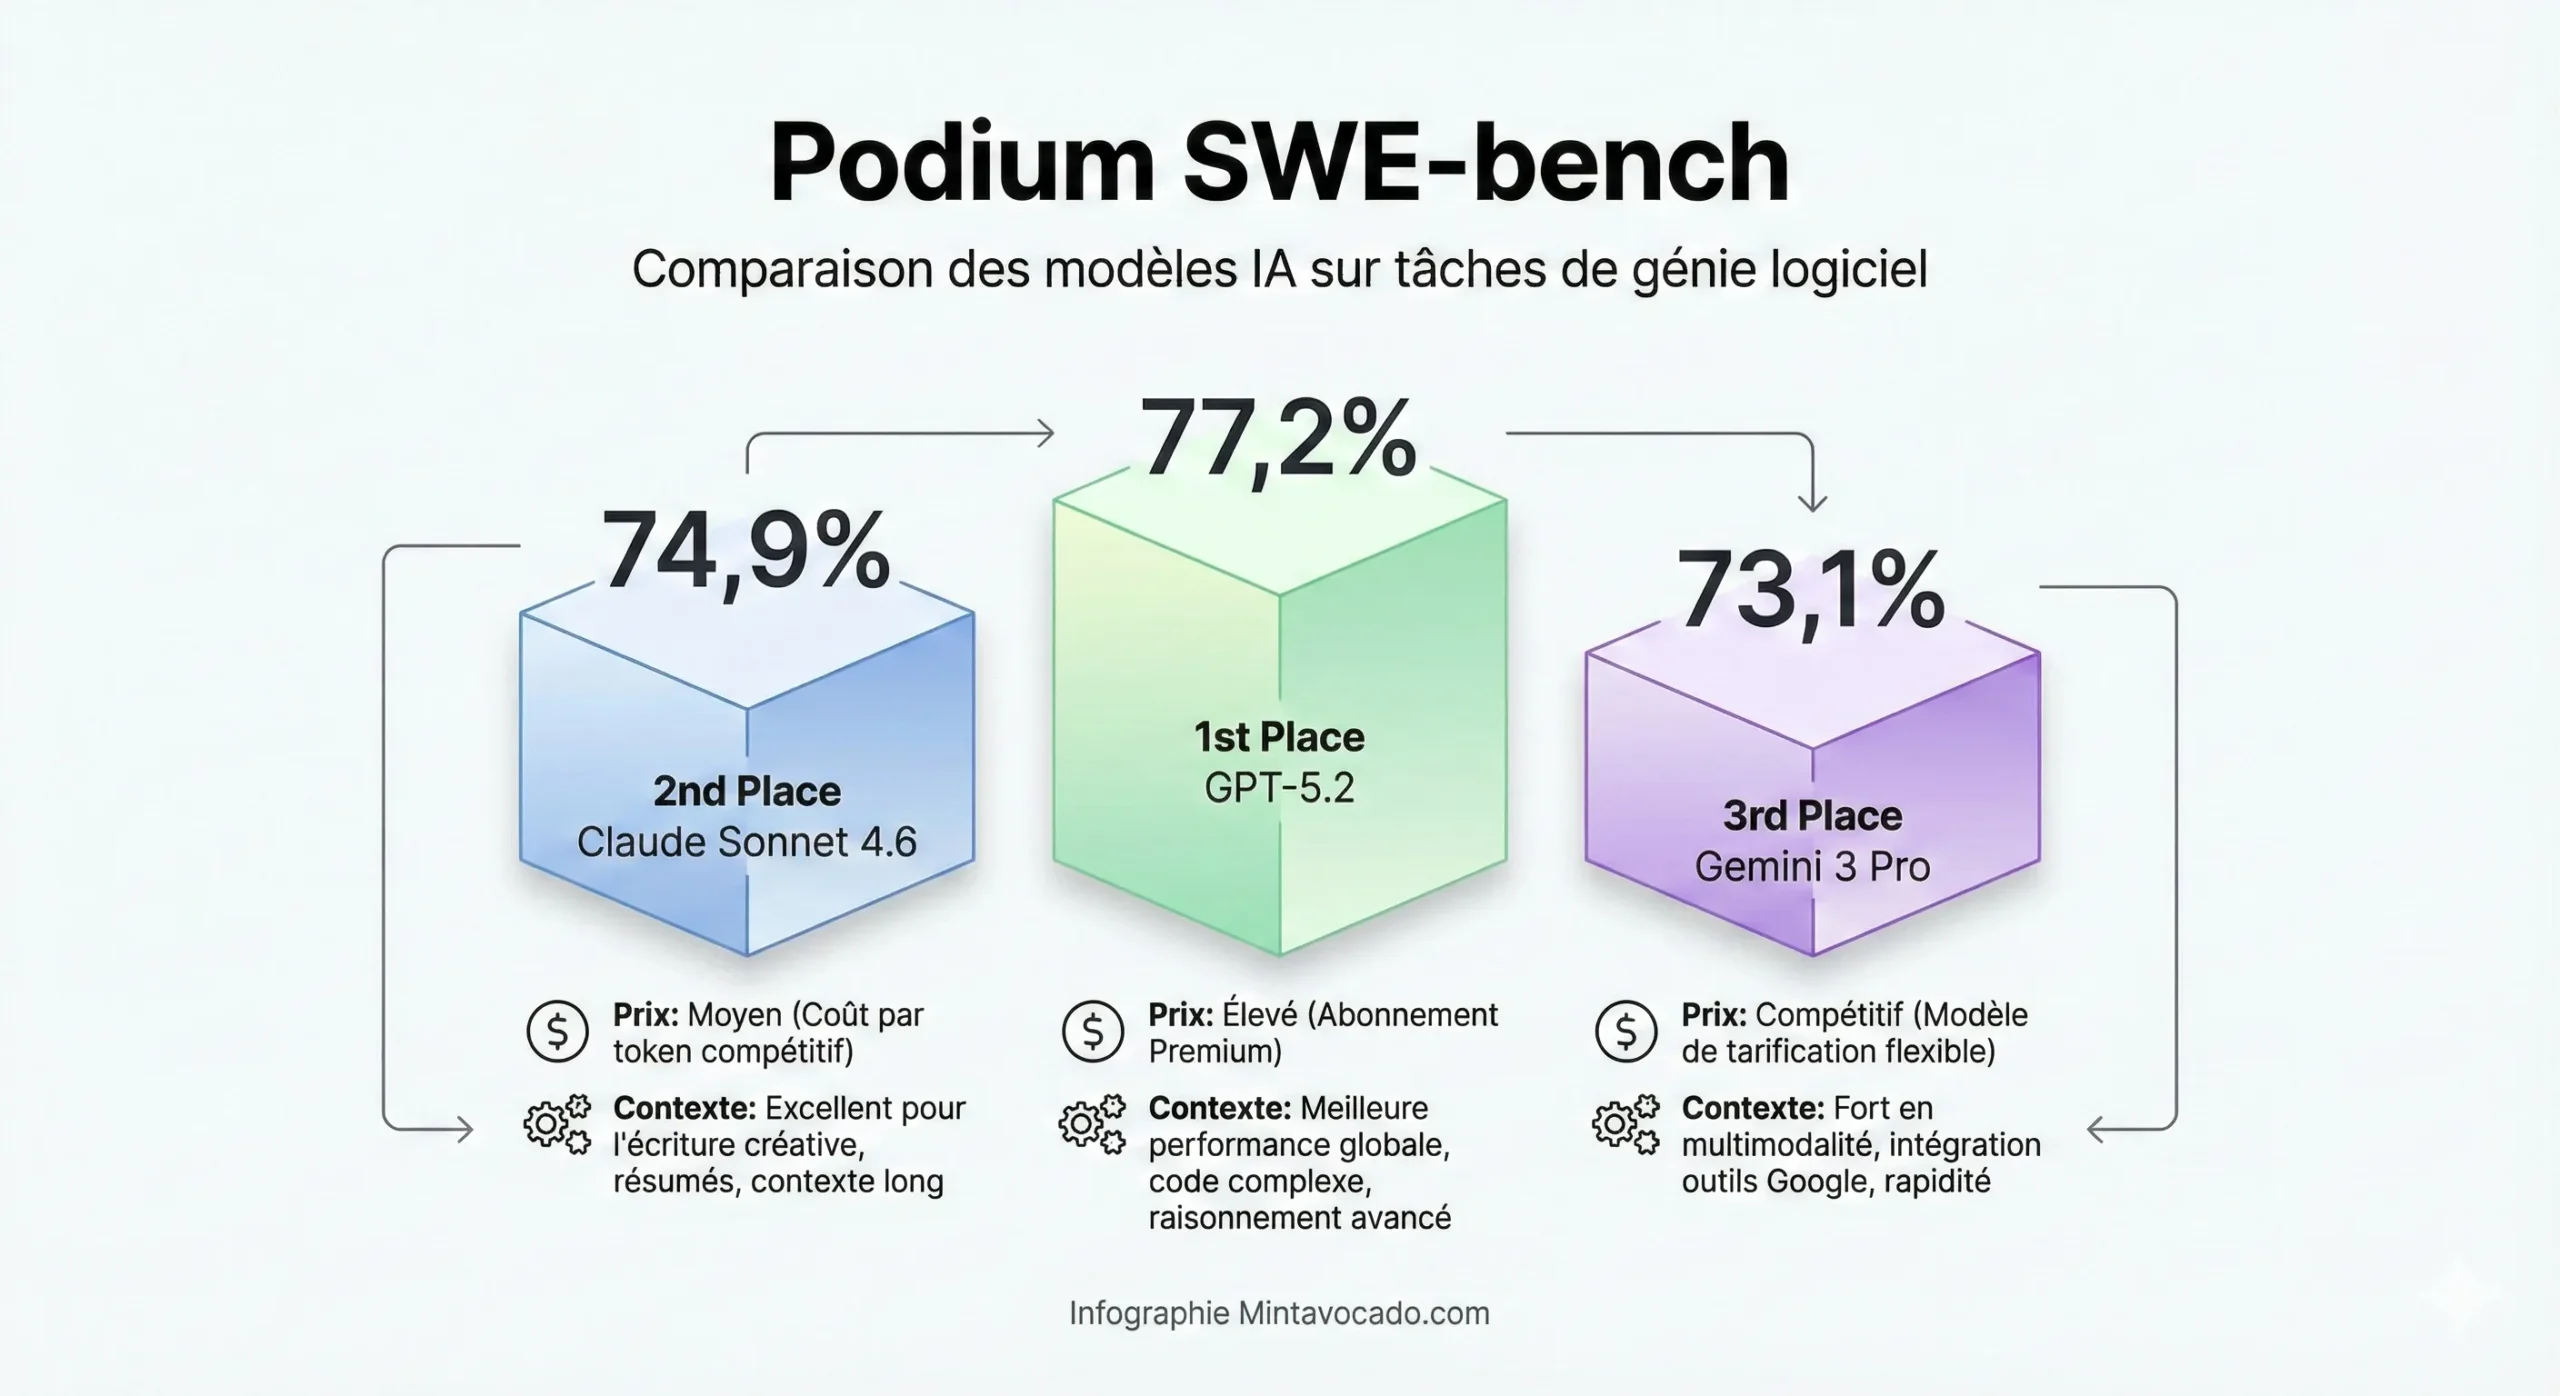
| Puesto | Modelo | SWE-bench | Diferencia con el #1 |
|---|---|---|---|
| 🥇 1 | Claude Sonnet 4.6 | 77,2 % | – |
| 🥈 2 | GPT-5.2 | 74,9 % | -2,3 pts |
| 🥉 3 | Gemini 3 Pro | 73,1 % | -4,1 pts |
Lo que estos números significan en la práctica: de 500 bugs reales sacados de GitHub, Claude resuelve 386, GPT-5.2 resuelve 374 y Gemini 3 Pro resuelve 365. La diferencia entre el primero y el último son 21 bugs de 500. Ya no estamos en el orden de magnitud, estamos en los detalles.
Redacción web y contenido: ¿quién escribe mejor?
La pregunta que mis lectores me han hecho en bucle esta semana. Aquí va mi respuesta desde el terreno. Y como programar y redactar no lo cubren todo, también he confrontado estos modelos con casos reales de marketing en mi guía de flujos de automatización.
Ranking de redacción (mi test personal, artículos de 1.000 palabras):
- Claude Sonnet 4.6 🥇: el más natural. El texto fluye, el tono es humano, las transiciones son suaves. Ideal para artículos de blog, newsletters, redacción SEO. Y también para la documentación
- GPT-5.2 🥈: muy preciso técnicamente. Excelente para tutoriales, emails B2B, contenidos estructurados. Menos poético, pero tremendamente eficaz
- Gemini 3 Pro 🥉: limpio, documentado, pero frío. Su verdadero talento en redacción: sintetizar documentos largos (gracias a sus 1M tokens). Peor en creatividad pura
Mi veredicto de profesional: Para el 80 % de mis necesidades editoriales, Claude Sonnet 4.6 produce el mejor resultado a la primera. Para redactar a partir de un PDF de 300 páginas, Gemini 3 Pro es imbatible. Para ir más lejos, en mi comparativa Gemini vs ChatGPT detallo los casos de uso.
El coste real: lo que vas a pagar de verdad
Porque la mejor herramienta es la que sigue siendo asequible en el uso diario.
Este es el coste mensual simulado para un equipo de 10 desarrolladores (20M tokens de entrada + 5M tokens de salida al mes):
| Modelo | Coste mensual estimado |
|---|---|
| Gemini 3 Flash | 25 $/mes |
| GPT-5.2 (batch) | 52,50 $/mes |
| Gemini 3 Pro | 100 $/mes |
| Claude Sonnet 4.6 | 135 $/mes |
Lo que dice esto: Claude Sonnet 4.6 es el más caro, y aun así domina los benchmarks. Es la opción «premium justificada». Gemini 3 Pro ofrece la mejor relación rendimiento/precio de los modelos de gama alta. Y si quieres ver cómo apliqué esto en mi propio negocio, te cuento cómo bajé mi factura de IA.
Top 3 de casos de uso: mi veredicto final
Así es como los uso yo en persona, y cómo aconsejo usarlos:
🥇 1. Claude Sonnet 4.6, para programar y redactar a diario
El nuevo go-to para los profesionales que hacen las dos cosas. Código complejo, artículos, documentación. El parámetro effort permite optimizar el coste según la tarea.
🥈 2. Gemini 3 Pro, para los proyectos grandes y el análisis multimodal
Cuando tu codebase supera lo que los demás pueden ingerir, o cuando necesitas analizar vídeos y audios además de texto. Precio imbatible para ese nivel de capacidad.
🥉 3. GPT-5.2, para los equipos que ya viven en el ecosistema OpenAI
Si ya usas ChatGPT, los plugins de OpenAI o haces React/TypeScript en producción, no cambies. GPT-5.2 sigue siendo excelente y su 74,9 % en SWE-bench está muy lejos de ser una vergüenza.
Preguntas frecuentes (PAA y feedback del terreno)
¿Claude Sonnet 4.6 es realmente mejor que Claude Opus 4.6 para código?
Sí, según la propia Anthropic. Sonnet 4.6 alcanza un rendimiento cercano al de Opus con un coste mucho menor. Para código y redacción diaria, Sonnet 4.6 es ya la opción recomendada. Opus 4.6 solo merece la pena para tareas de razonamiento extremadamente complejas.
¿Gemini 3 Pro puede leer de verdad 1 millón de tokens?
Sí, es la ventana de contexto estándar de Gemini 3 Pro. En comparación, Claude Sonnet 4.6 está en 200K (1M en beta) y GPT-5.2 en 128K. Para los proyectos grandes, es la diferencia entre leer un capítulo o el libro entero.
¿Qué modelo elegir para una estrategia de contenido SEO?
Claude Sonnet 4.6 es mi opción número 1 para redacción SEO. Produce el texto más natural, el mejor estructurado, y gestiona muy bien las instrucciones editoriales largas. GPT-5.2 es un excelente backup para artículos muy técnicos. Si lo que buscas es el método completo, mi plan SEO basado en datos lo explica paso a paso.
¿GPT-5.2 sigue siendo relevante frente a Claude Sonnet 4.6?
Sin duda. GPT-5.2 es segundo en código (74,9 % en SWE-bench) y primero en JavaScript/TypeScript/React con un 90-92 % de precisión. Su ecosistema (plugins, batch API, integraciones) sigue siendo imbatible. No está obsoleto, está especializado.
¿Puedo usar Gemini 3 Pro gratis?
Gemini 3 Pro se desplegó para todos los usuarios en la app Gemini el 11 de febrero de 2026, con límites superiores para los suscriptores de Google AI Plus, Pro y Ultra. El acceso por API es de pago.
Lo que me habría gustado saber antes de probarlos
Tres lecciones de profesional que las reviews clásicas no cuentan:
- No busques el modelo universal. Las diferencias de benchmark (4 puntos entre Claude y Gemini) son demasiado pequeñas para justificar una elección única. El caso de uso manda.
- El coste pesa a largo plazo. En uso intensivo, Gemini 3 Pro es un 26 % más barato que Claude con un rendimiento muy parecido en código.
- El parámetro
effortde Claude Sonnet 4.6 lo cambia todo. Ponereffort: mediumen las tareas rutinarias reduce la factura sin sacrificar calidad. La mayoría de los usuarios todavía no lo sabe.
¿Cuál de los tres usas a diario? Dímelo en comentarios, y si tienes un test concreto que proponer, lo hago en mi próximo vídeo.


Deja una respuesta